Rodzaje halucynacji: fakty, źródła, kod, obliczenia
- Fakty, np. zmyślone daty, nazwiska, wydarzenia czy parametry produktów. Model poda np. datę premiery biblioteki z dokładnością do dnia, choć nigdzie jej nie „widział”.
- Źródła i cytaty, czyli nieistniejące publikacje, linki prowadzące donikąd, zmyślone orzeczenia czy numery przepisów.
- Kod i API, czyli nieistniejące funkcje, parametry, flagi CLI czy wersje bibliotek. Szczególnie groźne są zmyślone nazwy pakietów. Na tym zjawisku opiera się atak nazywany slopsquattingiem: przestępcy rejestrują w publicznych rejestrach pakiety o nazwach, które modele często wymyślają, i czekają, aż ktoś zainstaluje je z podpowiedzi AI.
- Obliczenia i logika, błędne sumy, procenty, konwersje jednostek czy wyliczenia dat, np. liczby dni roboczych w danym okresie. Model „liczy” tekstem, a nie kalkulatorem, więc przy dłuższych obliczeniach łatwo o pomyłkę.
Halucynacje AI w pracy programisty i rekrutera – przykłady
Programista: nieistniejąca metoda
Asystent kodu podpowiada metodę biblioteki, która brzmi sensownie, ale nie istnieje w używanej wersji (np. pojawiła się dopiero w nowszej albo nigdy jej nie było).
W najlepszym razie skutkiem będzie błąd kompilacji. W gorszym – w bibliotece istnieje metoda o podobnej nazwie, która robi coś innego, i kod działa, ale zachowuje się inaczej, niż zakładasz.
Jak to wykryć? Sprawdź dokumentację dla swojej wersji biblioteki, korzystaj z typowania i podpowiedzi IDE, a przede wszystkim pisz testy, które sprawdzą faktyczne zachowanie.
Rekruter IT: opis kandydata lub stanowiska
AI streszcza CV i dodaje technologie, których kandydat nie wymienił, bo „pasują” do profilu (np. Kubernetes u DevOpsa). Albo generuje treść ogłoszenia z wymaganiami, których nie było w briefie od hiring managera.
Skutkiem może być niesprawiedliwa ocena kandydata, nietrafione zaproszenia na rozmowę, ogłoszenie przyciągające niewłaściwe osoby.
Jak to wykryć? Zawsze porównuj streszczenie z oryginałem CV i briefu. Decyzje rekrutacyjne podejmuje człowiek po weryfikacji, a nie model.
Jak rozpoznać halucynację?
Najważniejsza zasada: pewny ton i szczegółowość nie są dowodem poprawności. Model, który podaje dokładną datę, nazwisko i numer wersji, wcale nie jest bardziej wiarygodny od modelu, który odpowiada ogólnikowo. Często jest wręcz odwrotnie, bo zmyślone szczegóły brzmią przekonująco.
Poznaj 5 sygnałów ostrzegawczych
- Bardzo konkretne liczby, daty i cytaty bez wskazanego źródła.
- Linki i tytuły publikacji, których nie da się otworzyć ani znaleźć.
- Nazwy funkcji, parametrów lub pakietów, których nie ma w dokumentacji.
- Różne odpowiedzi na to samo pytanie zadane kilka razy.
- Odpowiedź, która idealnie potwierdza założenie zawarte w pytaniu.
Jak ograniczyć halucynacje AI?
Trzeba powiedzieć to wprost: obecnie żadna technika nie eliminuje halucynacji w 100%. Najlepsze efekty daje łączenie kilku metod – od prostych nawyków przy pisaniu promptów po rozwiązania inżynierskie w aplikacjach opartych na LLM.
- Zamiast pytać model o coś „z pamięci”, wklej dokument, fragment dokumentacji albo dane, na których ma pracować. Model, który ma źródło przed sobą, zmyśla dużo rzadziej.
- Wprost napisz, że odpowiedź „brak danych” jest akceptowalna. To zdejmuje z modelu presję na zgadywanie.
- Gdy model musi wskazać, skąd wziął daną informację, łatwiej wyłapiesz miejsca, w których coś dopisał.
- Zamiast jednego wielkiego polecenia („przeanalizuj i podsumuj i zaproponuj”) daj kilka mniejszych i sprawdzaj wynik każdego z nich.
Więcej o budowaniu skutecznych poleceń przeczytasz w artykule Prompt engineering od podstaw.
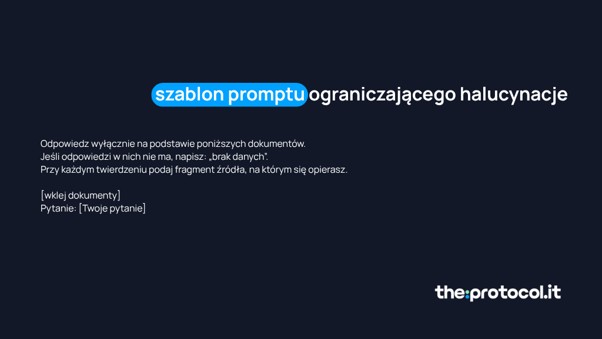
Szablon promptu ograniczającego halucynacje
Odpowiedz wyłącznie na podstawie poniższych dokumentów. Jeśli odpowiedzi w nich nie ma, napisz: „brak danych”. Przy każdym twierdzeniu podaj fragment źródła, na którym się opierasz.
[wklej dokumenty]
Pytanie: [Twoje pytanie]
Jakie ryzyka niosą halucynacje AI?
Pojedyncza halucynacja w czacie to drobiazg. Halucynacja, która trafi do kodu produkcyjnego, oferty dla klienta albo decyzji o kandydacie, może kosztować dużo więcej. Poniżej najważniejsze kategorie ryzyka. To przegląd ogólny, a nie porada prawna.
- Bezpieczeństwo. Podatny lub złośliwy kod, zmyślone pakiety przejęte przez atakujących, błędne konfiguracje uprawnień czy reguł sieciowych. O tym, jak bezpiecznie pracować z kodem generowanym przez AI, piszemy w artykule Vibe coding – czy kodowanie z AI jest bezpieczne?
- Biznes i reputacja. Błędne informacje w komunikacji z klientem, raportach czy dokumentacji technicznej. Szczególnie ryzykowne są chatboty obsługi klienta, które potrafią „obiecać” warunki, rabaty czy zasady zwrotów, których firma nigdy nie oferowała.
- Odpowiedzialność. Za treść i decyzje odpowiada człowiek albo organizacja, a nie model. Tłumaczenie „tak napisało AI” nie zwalnia z odpowiedzialności wobec klienta, pracodawcy ani sądu. Dlatego przepisy coraz częściej wymagają nadzoru człowieka nad systemami AI.
Jeśli pracujesz w HR lub rekrutacji i korzystasz z narzędzi AI do oceny kandydatów, przeczytaj nasz przewodnik po AI Act w HR i rekrutacji.
FAQ – Najczęstsze pytania o halucynacje AI
Czy da się całkowicie wyeliminować halucynacje AI?
Nie, przy obecnej technologii halucynacji AI nie da się całkowicie wyeliminować. Wynikają one z samej zasady działania modeli językowych, które przewidują najbardziej prawdopodobny ciąg słów, a nie sprawdzają faktów.
Dlaczego ChatGPT i inne modele podają nieprawdziwe informacje?
Bo są trenowane do generowania wiarygodnie brzmiącego tekstu, a nie do odróżniania prawdy od fałszu. Gdy model nie zna odpowiedzi, uzupełnia lukę najbardziej prawdopodobnym ciągiem słów, zamiast przyznać, że nie wie.
Jak sprawdzić, czy odpowiedź AI jest prawdziwa?
Najpewniejszy sposób to weryfikacja w źródle pierwotnym: dokumentacji, akcie prawnym albo oryginalnych danych. Poproś model o źródła i sprawdź je samodzielnie, bo linki i tytuły publikacji też mogą być zmyślone. Pomaga zadanie tego samego pytania kilka razy – rozbieżności w szczegółach sugerują, że model zgaduje.
Może Ci się spodobać:
Aleksandra SudnikWielbicielka kinematografii, gry w tenisa, włoskiej kuchni i content marketingu. Magister psychologii biznesu, podcasterka, prelegentka, redaktorka, autorka e-booków oraz managerka w agencji marketingowej Fox Strategy.


 4 min.